百PB级海量存储系统的强一致性与高可靠性实践
在数据驱动业务决策的今天,构建一个能够稳定运转上万块磁盘、承载百PB级数据的海量存储系统,是对架构设计与工程实现的极致考验。这类系统不仅要为各类数据处理与存储服务提供基础支撑,还必须在面对硬件故障常态化、数据规模爆炸式增长的现实下,确保数据的强一致性(Strong Consistency)与系统的高可靠性(High Reliability)。这两大特性相互交织,共同构成了大规模存储系统的基石。
强一致性要求任何时刻,所有客户端对同一数据的读取都能获得最近一次写入的值。在万盘规模的集群中,网络分区、磁盘慢盘、节点宕机等扰动频繁发生,实现强一致性面临巨大挑战。实践中通常采用基于Quorum的副本协议(如Paxos、Raft等)来构建一致性层:每次写入需要多数派副本确认后才返回成功,读取时同样通过Quorum校验来保证获取最新数据。为了避免大规模集群下的长尾延迟,系统会引入代理(Proxy)层将请求路由到主副本(Leader),并结合 leases 机制减少读操作的协调开销。对于元数据管理,采用全局有序的分配服务与多版本并发控制(MVCC)来保障跨数据分片事务的严格串行化。强一致性的代价是更高的延迟与更复杂的故障恢复逻辑,但百PB级系统承载的多为关键业务数据,放弃强一致性意味着应用层需要处理复杂的数据冲突,成本远高于存储层内部的协调。
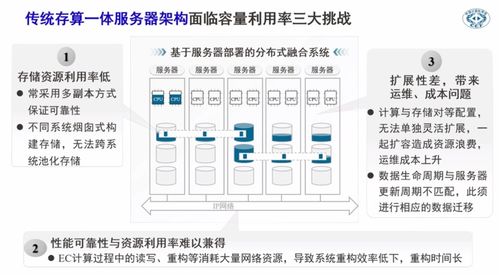
高可靠性则要求系统在任意组件故障时仍能提供不间断服务,并保证数据不丢失。面对上万块磁盘,年化故障率意味着每天都有磁盘下线。系统通过多副本(通常为3副本)或纠删码(Erasure Coding)技术将数据分散到不同故障域(机架、电源、交换机)中,确保单一甚至多重故障下数据依然可用。副本放置算法需均衡考虑容量、负载与故障隔离,避免热点。更关键的是故障检测与自愈能力:每个磁盘和节点都有心跳监控,一旦发现异常立刻启动数据重建。在万盘规模下,重建过程需严格控制限速,避免压垮正常业务;同时引入主动复制与增量校验,确保重建期间数据的一致性。可靠性还依赖端到端的数据校验(Checksum)和静默错误(Silent Data Corruption)的检测与修复,以及跨数据中心的异地容灾(如同一份数据的部分副本分布在不同城市)。
数据处理与存储服务作为上层业务,必须在强一致性与高可靠性的存储底座上构建。对接收数据流,构建幂等写入通道,通过唯一的版本号避免重复数据;对读取服务,依据一致性级别要求灵活选择Strong Read或Bounded Stale Read,但核心交易场景应采用强一致读。离线计算任务与实时查询服务共享同一份强一致副本,减少复制链路,同时也要求存储系统提供高吞吐的顺序写与随机读能力,支持多种并发访问模式。运维体系则是高可靠性的最后一道防线,包括容量预测、磁盘均衡、故障演练和自动化恢复流程,均需在仿真环境中反复验证。只有数据层与服务层的协同设计,才能在成本、一致性与可用性之间找到最佳平衡,让百PB级存储系统长期稳定运行。
如若转载,请注明出处:http://www.lqcg88.com/product/112.html
更新时间:2026-11-07 13:10:03